
Consulta la normativa de edificación sin que te sangren los tokens
Un repositorio público, una pregunta que puedes copiar y lo que aprendí al medir el consumo de tokens.
De dónde sale Normativa Abierta
Un usuario de Pic on Site me comentó que gastaba muchos tokens al analizar normativa con IA. Un token es un trozo de texto que el modelo lee o escribe. Quería saber si podía darle menos texto y que aun así encontrara la nota al pie o la excepción que cambia la respuesta.
De ahí salió Normativa Abierta. La idea es llegar antes a la página que hace falta y poder volver al documento original para comprobar la cita. Si tu presupuesto para IA ronda los 20 € al mes, puedes empezar por el chat que ya usas. Para probar el enlace no hace falta contratar otro servicio.
Qué ahorró tokens en la prueba
En el piloto del DB-SUA, el documento del CTE sobre seguridad de utilización y accesibilidad, comparé dos formas de consultar la misma edición de la norma. Una buscaba fragmentos en el PDF indexado. La otra usaba un programa local, el adaptador, para seleccionar hasta tres páginas por consulta y pasárselas al modelo con su referencia. Usé el mismo modelo (GPT-5.4 mini) y los mismos planos simulados: ocho casos, repetidos tres veces por método.
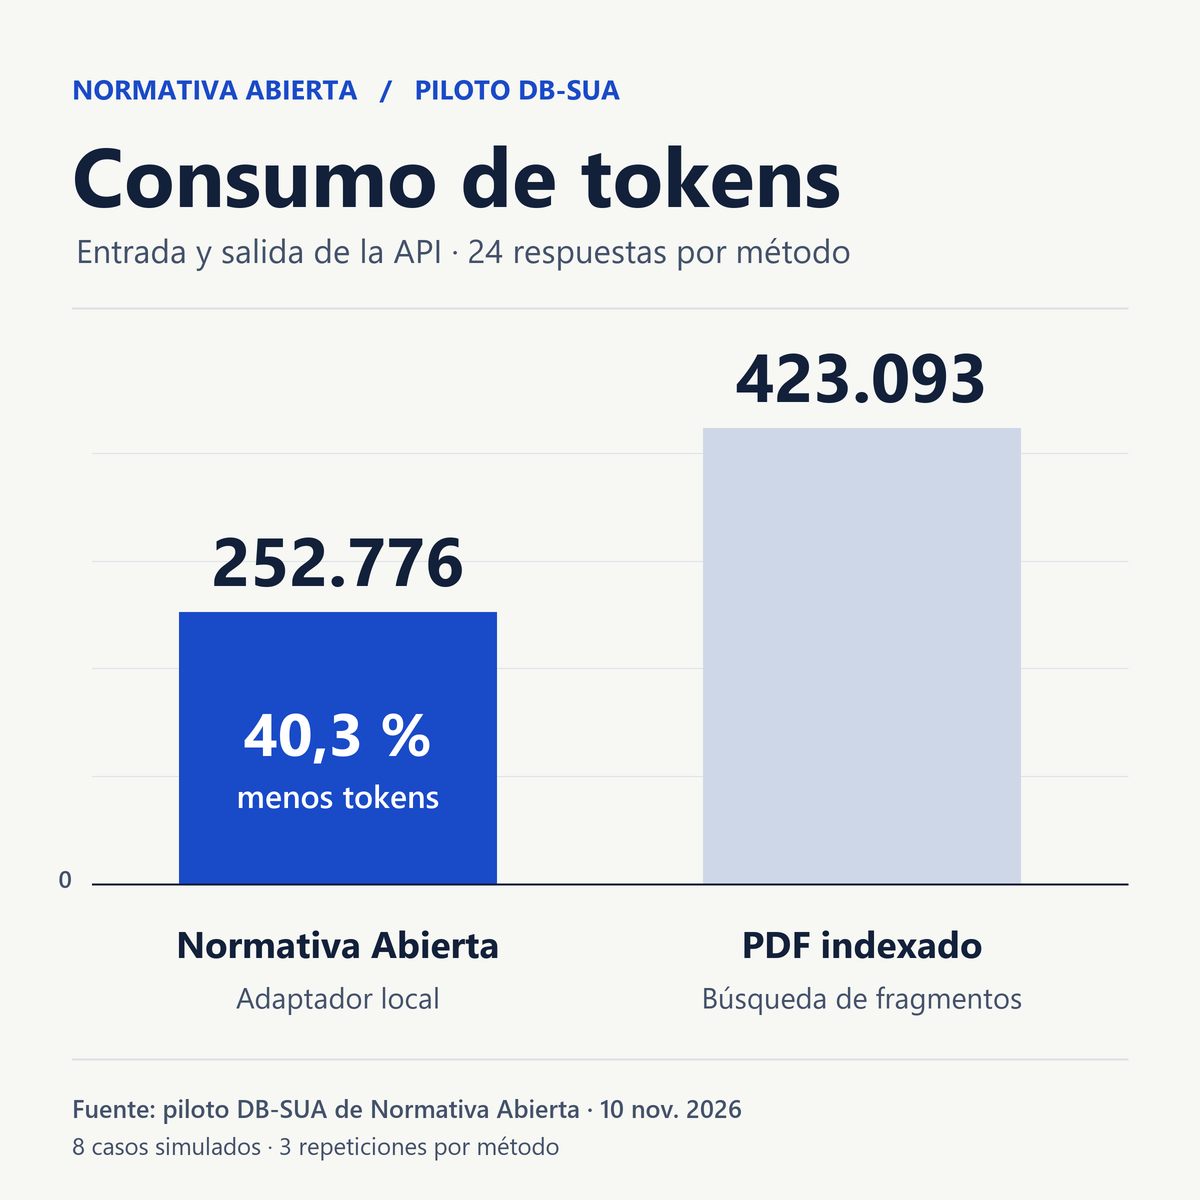
- Consumo total: 252.776 tokens con el adaptador y 423.093 con el PDF indexado.
- Veredicto esperado: 24 de 24 con el adaptador y 23 de 24 con el PDF indexado.
- Todos los criterios, incluidas las citas aplicables: 23 de 24 con el adaptador y 3 de 24 con el PDF indexado.
El adaptador consumió un 40,3 % menos de tokens contando la entrada y la salida de la API. La mayor parte de la diferencia estuvo en el texto que recibió el modelo: en este montaje las páginas se entregaban directamente, sin pedirle que buscara fragmentos. En cuanto a calidad, muchas respuestas con el PDF indexado acertaron el veredicto pero citaron otra página. El adaptador también se equivocó en una cita.
Solo tres pares pasaron todos los criterios con ambos métodos: las tres repeticiones del caso en que faltaba la edición y tocaba decirlo. La revisión fue por IA. Queda por comprobar el ahorro a igualdad de calidad en consultas que sí se pueden resolver y con planos reales revisados por un técnico. El 40,3 % corresponde al consumo por API en este piloto; no mide cuánto dura una suscripción de ChatGPT o Claude.
Pega el enlace y haz una pregunta
Copia este ejemplo en ChatGPT o Claude con acceso web. Puedes cambiar la pregunta por la tuya:
Abre https://github.com/pedenry/normativa-abierta y sigue el enlace al visor. ¿Qué condiciones recoge la edición del 14 de junio de 2022 del DB-SUA para la anchura libre de un pasillo de uso administrativo en un itinerario accesible? Indica la edición, el apartado, la página del PDF y el enlace directo. Incluye las notas y excepciones que correspondan. Si no puedes abrir la página o falta esa edición, dímelo.
Para esta vía no necesitas instalar nada ni tener una cuenta de GitHub. El chat puede quedarse en la portada; si pasa, abre el visor público y pásale el enlace de la página concreta. Comprueba la cita en el PDF original, sobre todo si intervienen tablas, fórmulas o dibujos, y confirma qué edición se aplica a tu caso.
Pegar el enlace no ejecuta el adaptador del piloto. Para usarlo, descarga el repositorio y sigue la guía de uso local: necesitas Python 3.12 o posterior, y puedes ejecutarlo tú o pedirle a un asistente con acceso a esa carpeta. El programa busca por términos y edición, entrega el texto de las páginas y avisa si falta la edición. Esa búsqueda local no necesita una clave de API ni un servidor.
Qué hay dentro del repositorio
Hay 31 PDF redistribuibles, con 1.582 páginas y 3.033 fragmentos. Son 15 documentos normativos —incluidos el CTE, el RITE y el reglamento de incendios industriales— y 16 guías con permiso para compartirlas. El corpus es parcial y la extracción automática aún no tiene una revisión técnica completa.
- Contenido e índices: PDF, apartados y páginas, con edición, enlace original y huella del archivo para identificar la copia.
- Visor: navegación por materia, documento, apartado y página.
- Adaptador, evaluación e historial: el programa de consulta, las pruebas y sus resultados. Los permisos de cada fuente están en Licencias.
Qué probé antes
- Primeros índices y servidor experimental. La primera búsqueda local no mostró ahorro en la consulta mediana. Un índice web experimental manejó más texto y falló en dos preguntas reformuladas. El prototipo HTTP redujo un 76,4 % el volumen total de texto de consulta en 43 casos, aunque en uno aumentó. Ese recuento era del texto del prototipo, no del consumo de un modelo.
- ChatGPT con el enlace frente a adjuntar el PDF. En tres preguntas, ambas vías cubrieron los 15 criterios de contenido, con diferencias en las citas. En el caso del DB-SI, el texto de las dos páginas citadas sumaba 1.989 tokens frente a 69.587 de todo el PDF. Eso compara tamaños de texto: el chat no mostró cuánto consumió. No repetí esa comparación en Claude.
- GitHub, PDF indexado y PDF completo por API. Partir del enlace raíz consumió 73.980 tokens, frente a 44.757 con el PDF indexado y 338.241 con el PDF completo. El enlace cubrió solo 4 de 15 criterios, frente a 12 y 10. En dos casos el modelo ni siquiera llegó a la disposición pertinente. De poco sirve gastar menos si falta justo la página que necesitas.
El próximo paso que me interesa es repetir la prueba con planos autorizados y revisión técnica humana. Si lo pruebas, cuéntame qué pregunta pública usaste y a qué página te mandó el chat. Y si quieres aportar un caso, corregir una referencia o ampliar el corpus, aquí está la guía para colaborar.